Haystack Nedir? Pipeline, Document Store ve Production RAG
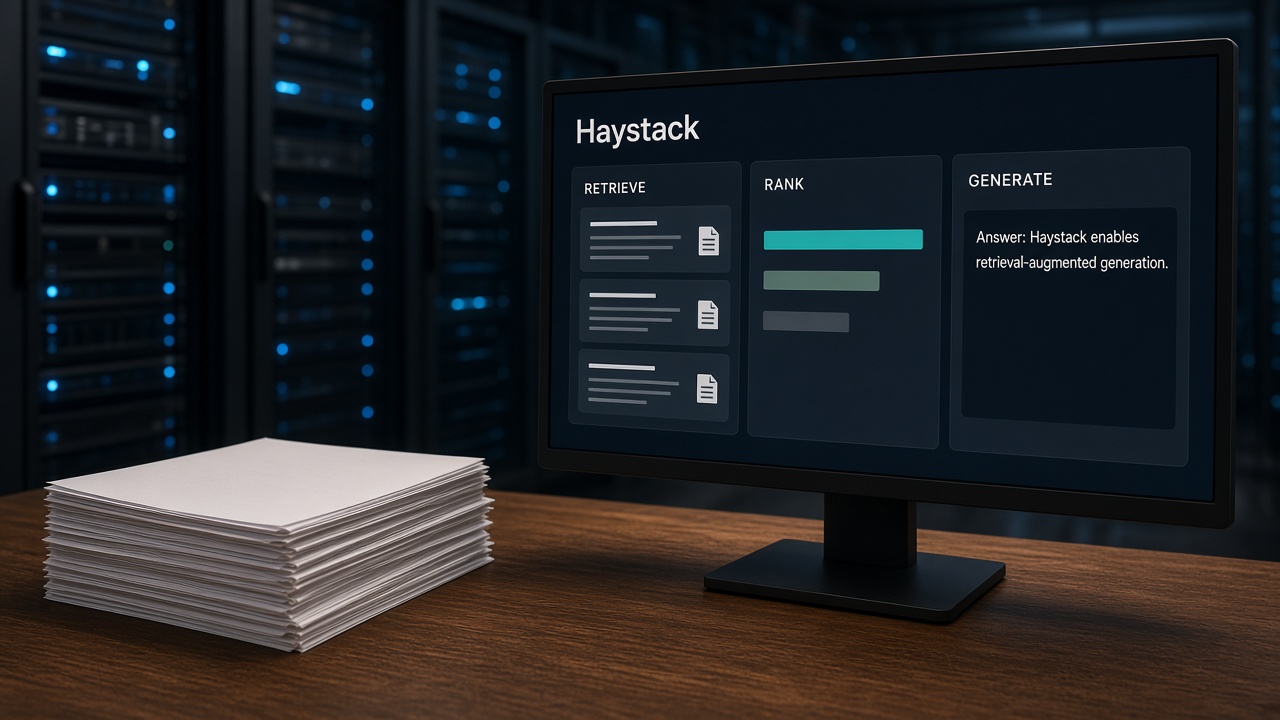
Haystack, deepset’in açık kaynak LLM orkestrasyon çatısıdır. Modeli veya vektör veritabanını değiştirmez; belgeyi parçalayıp arayan, sıralayan ve üreticiye soran pipeline’ı tek graf üzerinde tutar.
RAG projeleri çoğu zaman bir embedding çağrısı ve bir prompt ile başlar. İlk demo yürür. Sonra aynı soruya hem anahtar kelime hem vektör bakmak, kiracıya göre filtrelemek, düşük skorlu pasajı modele sokmamak, cevabın hangi sayfadan geldiğini saklamak ve bu grafı test etmek istersiniz. O noktada zincir, dosyaların içine dağılmış fonksiyon çağrılarına döner. Haystack bu dağılımı bileşen ve bağlantı diye yazar.
Paket adı haystack-ai. Lisans Apache-2.0. Bugün kullanılan nesil Haystack 2: 2024’te gelen yeniden yazım. Eski sürümdeki node grafının yerini, girişi ve çıkışı belirli bileşenler aldı. Dokümantasyon docs.haystack.deepset.ai üzerinde.
Hangi katmanda durur
Üç şeyi ayırmak lazım. Üretici model, vLLM veya hosted bir API arkasında token üretir. Document store, pasajları ve embedding’leri saklar. Haystack ikisinin arasındaki akıştır: dosyayı belgeye çevir, parçala, göm, yaz, sorguyu aynı uzayda ara, gerekirse yeniden sırala, prompt’u kur, modeli çağır, dönen cevabı kaynak belgelerle birlikte geri ver.
Bu ayrım production’da işe yarar. Modeli Qwen’den başkasına çekmek generator bileşenini değiştirir. Elasticsearch’ten Pgvector’a geçmek store ve retriever’ı değiştirir. Parça boyutu, prompt ve filtre aynı kalabilir. Framework’ün bedeli budur; her şeyi elle bağladığınızda bu değişim üç dosyaya yayılır.
Bileşen ve pipeline
Bileşen tek iş yapar. PDF okur, metni böler, embedding üretir, arar, prompt doldurur veya sohbet tamamlama çağırır. Birbirini tanımaz. Pipeline, çıkış soketini giriş soketine bağlayan yönlü graftır. Bağlantı tipi uymazsa çizim sırasında patlar; gece yarısı yanlış listeyi modele vermez.
Graf düz bir hat olmak zorunda değil. Hibrit aramada iki retriever paralel çalışır, bir joiner sonuçları birleştirir. Agent, araç çağırdıktan sonra aynı pipeline’ın içine geri dönebilir. Üst sınır olarak bir bileşenin kaç kez çalışacağı da tanımlıdır; sonsuz araç döngüsü varsayılan olarak kesilir.
Çalıştırma iki sözlükle olur. run her bileşene kendi girdisini verir. Çıktı da bileşen adına göre döner. Ara adımı görmek için o bileşenin çıktısını isteğe eklemek yeter. “Model saçmaladı” dediğinizde retriever’ın getirdiği pasajlar hâlâ elinizdedir.
İki hat vardır: indeks ve sorgu
Aynı store’u iki pipeline kullanır. İlki belgeyi içeri alır, ikincisi soruya cevap verir. Bunları tek fonksiyonda birleştirmek, her soruda PDF’i yeniden parçalamanın yoludur.
İndeks hattı kabaca şöyle akar: dönüştürücü, bölücü, embedder, writer.
from haystack import Pipeline
from haystack.components.converters import PyPDFToDocument
from haystack.components.embedders import SentenceTransformersDocumentEmbedder
from haystack.components.preprocessors import DocumentSplitter
from haystack.components.writers import DocumentWriter
from haystack.document_stores.in_memory import InMemoryDocumentStore
from haystack.document_stores.types import DuplicatePolicy

document_store = InMemoryDocumentStore()

index = Pipeline()
index.add_component("converter", PyPDFToDocument())
index.add_component("splitter", DocumentSplitter(split_by="word", split_length=200, split_overlap=40))
index.add_component("embedder", SentenceTransformersDocumentEmbedder(model="BAAI/bge-m3"))
index.add_component("writer", DocumentWriter(document_store=document_store, policy=DuplicatePolicy.OVERWRITE))
index.connect("converter.documents", "splitter.documents")
index.connect("splitter.documents", "embedder.documents")
index.connect("embedder.documents", "writer.documents")

index.run({"converter": {"sources": ["sozlesme.pdf"]}})
InMemoryDocumentStore geliştirme içindir. Süreç kapanınca belge de gider. Production’da aynı arayüzün Elasticsearch, OpenSearch, Pgvector, Qdrant veya Weaviate uyarlaması durur. Entegrasyonlar ayrı paket olarak gelir; çekirdek, store’u tanımadan retriever’a bağlanır.
Parça boyutu his değil, ölçümdür. Sözleşmede 200 kelime ve 40 kelime overlap makul bir başlangıçtır. Fatura satırı, madde madde yönetmelik ve serbest rapor aynı split_length ile yaşamaz. Sayfa numarası ve dosya adı metadata’da kalmazsa, model doğru cümleyi bulsa bile kullanıcıya “hangi sayfa” diyemezsiniz. Dönüştürücünün çıkardığı meta’yı bölücüden sonra da taşıyın.
Sorgu hattı
Sorgu tarafında retriever, prompt ve generator vardır. Aşağıdaki örnek kasıtlı olarak BM25. Embedding’siz de pipeline’ın şekli görünür. Üretici, OpenAI sohbet API’sine konuşur; adres lokal bir sunucu da olabilir.
from haystack import Document, Pipeline
from haystack.components.builders import ChatPromptBuilder
from haystack.components.generators.chat import OpenAIChatGenerator
from haystack.components.retrievers.in_memory import InMemoryBM25Retriever
from haystack.dataclasses import ChatMessage
from haystack.utils import Secret

document_store.write_documents([
    Document(
        content="Fesih bildirimi yazılı yapılır ve karşı tarafa ulaştığı gün hüküm doğurur.",
        meta={"source": "sozlesme.pdf", "page": 4, "tenant_id": "acme"},
    ),
])

prompt = [
    ChatMessage.from_system(
        "Yalnızca belgelere dayan. Belgede yoksa bilmiyorum de.\n"
        "{% for doc in documents %}- {{ doc.meta.source }} s.{{ doc.meta.page }}: {{ doc.content }}\n{% endfor %}"
    ),
    ChatMessage.from_user("{{ question }}"),
]

pipe = Pipeline()
pipe.add_component("retriever", InMemoryBM25Retriever(document_store=document_store, top_k=5))
pipe.add_component(
    "prompt",
    ChatPromptBuilder(template=prompt, required_variables={"question", "documents"}),
)
pipe.add_component(
    "llm",
    OpenAIChatGenerator(
        api_key=Secret.from_token("degistirin"),
        model="Qwen/Qwen2.5-7B-Instruct",
        api_base_url="http://gpu-box:8000/v1",
    ),
)
pipe.connect("retriever.documents", "prompt.documents")
pipe.connect("prompt.prompt", "llm.messages")

question = "Fesih ne zaman hüküm doğurur?"
result = pipe.run({
    "retriever": {"query": question},
    "prompt": {"question": question},
})
print(result["llm"]["replies"][0].text)
api_base_url generator’ı OpenAI uyumlu herhangi bir uca çevirir. Önceki nottaki vLLM sunucusu burada durur. Haystack token üretmez; KV cache, batch ve kuantizasyon o sürecin işidir. Prompt’a sayfa ve dosya adını basmak, cevabın izini logda bırakır. “Bilmiyorum” talimatı olmadan model, bağlam zayıfken kendi bilgisinden tamamlar. RAG’ın sessiz hatası budur.
Store, metadata, kiracı
Document; metin, metadata, isteğe bağlı yoğun ve seyrek embedding ve bir kimliktir. Store, pipeline bileşeni değildir. run metodu yoktur. Retriever ve writer onu kullanır.
Çok kiracılı sistemde tenant_id metadata’da durur ve retriever filtresi sorguya yapışır. Aksi halde bir müşterinin pasajı diğerinin cevabına karışır. Embedding uzayı paylaşılıyor olsa bile filtre, aramadan önce uygulanır. Bunu prompt’a “sadece acme belgelerine bak” yazarak çözmeye çalışmayın. Model o cümleyi ciddiye almayabilir; store alır.
PostgreSQL zaten duruyorsa Pgvector, ayrı bir vektör ürünü açmadan işi görür. Tam metin ile vektörü aynı sorguda isteyen işlerde Elasticsearch veya OpenSearch’ün hibrit retriever’ı daha doğal oturur. Seçim, “hangi marka popüler” değil, filtrenin, yedeklemenin ve ekibin zaten işlettiği motorun neresinde olduğudur.
Hibrit arama ve ranker
Tek başına vektör, madde numarası, ürün kodu ve tam adreste zayıftır. Tek başına BM25, “bu madde feshi anlatıyor mu” gibi paraphrased soruda zayıftır. Hibrit hat ikisini birden çalıştırır. Embedding retriever ile BM25 retriever paralel gider, DocumentJoiner listeleri birleştirir. Elasticsearch tarafında aynı iş reciprocal rank fusion ile store’un içinde de yapılabilir.
Retrieving ile ranking ayrıdır. İlk tur geniş olsun: yirmi pasaj. İkinci tur bir cross-encoder veya similarity ranker ile beşe insin. Modele giden bağlam kısalır, dikkat dağılmaz, token faturası düşer. Ranker’sız “top 20’yi prompt’a göm” yaklaşımı, uzun sözleşmede hem yavaşlar hem uydurmayı artırır.
Türkçe belgede embedding modelinin dili, parça kalitesi kadar belirler. İngilizce genel bir MiniLM, Türkçe yönetmelikte benzerliği kaçırabilir. bge-m3 çok dilli bir başlangıçtır; sizin korpusunuzda recall@5 ölçülmeden “en iyisi” diye sabitlenmez.
Agent ne zaman
Haystack 2’de Agent, araç çağıran bir bileşendir ve pipeline’ın içine oturur. Araç bir Python fonksiyonudur: stok bak, bilet aç, hesapla. Üretici araç şemasını görür, çağırır, sonucu sonraki tura taşır.
Sabit bir soru-cevap için agent gereksizdir. Hangi retriever’ın çalışacağı belli ise graf da bellidir; modeli araç seçmeye zorlamak hem gecikme hem maliyet ekler. Agent, adım sayısı soruya göre değişince anlam kazanır. Örnek: önce belge ara, cevap yoksa ikinci bir koleksiyona bak, hâlâ yoksa insan kuyruğuna yaz. Bu dallanma pipeline router’ı ile de yapılır. Router izi daha nettir. Agent izi ise araç log’udur. İkisini de “akıllı sistem” diye aynı kefeye koymayın.
Araç, yan etkisi olan bir işlemi (ödeme, kayıt silme, mail) modelin keyfine bırakmaz. Şema dar, yetki servis katmanında, dönüş metni kısa olsun. Hayhooks tarafında yaşam döngüsü kancaları bu sınır için var: çağrıdan önce kontrol, çıkışta maliyet sayacı.
Hayhooks ve .NET
Haystack Python’dur. .NET API’nin içine gömülmez. Aynı vLLM kararının tekrarı: orkestrasyon ayrı bir süreç, sözleşme HTTP.
Hayhooks, pipeline’ı veya agent’ı REST olarak açar. Varsayılan port 1416. Bir sarmalayıcı run_api yazdığınızda POST /sozlesme_rag/run oluşur. İsterseniz aynı süreç OpenAI uyumlu sohbet ucu da verir. İki uç birden şart değil. Soru-cevap için kendi şemanız daha dürüsttür; çünkü cevapla birlikte kaynak pasajları da dönmeniz gerekir. OpenAI sohbet şeması kaynak listesini taşımaz.
hayhooks run

curl -X POST http://127.0.0.1:1416/sozlesme_rag/run \
  -H "Content-Type: application/json" \
  -d "{\"question\":\"Fesih ne zaman hüküm doğurur?\"}"
var payload = new { question = userText };
using var client = new HttpClient();
using var response = await client.PostAsync(
"http://haystack-box:1416/sozlesme_rag/run",
new StringContent(JsonSerializer.Serialize(payload), Encoding.UTF8, "application/json"));
response.EnsureSuccessStatusCode();
var body = await response.Content.ReadAsStringAsync();Zaman aşımını retriever artı üreticiye göre ayırın. İndeks hattı sorgu hattından ayrı ölçeklensin; PDF patlaması, kullanıcı sorusunun kuyruğunu şişirmesin. Dönen gövdeye model adı, pipeline sürümü ve kullanılan pasajların kimliği girsin. Cevabı ERP’ye yazmadan önce şema ve “bilmiyorum” hali kontrol edilsin. Kaynaksız cevap, otomatik kayıt değildir.
Ölçmeden RAG tamamlanmış sayılmaz
İki skor ayrıdır. Retriever doğru pasajı ilk beşe getirdi mi. Generator o pasajlara sadık mı, yoksa boşluğu kendi doldurdu mu. Haystack’te faithfulness ve context relevance evaluator’ları ikinci soruya bakar. Birincisi için elle işaretlenmiş bir soru-pasaj seti yeter. İkisini tek “beğenildi” puanında eritmeyin.
- Recall@k. Doğru sayfa ilk k sonuçta var mı. Embedding modeli ve parça boyutu burada belli olur.
- Faithfulness. Cümleler gelen pasajlardan çıkıyor mu. Ranker ve prompt burada belli olur.
- Abstain. Belgede olmayan soruda model uyduruyor mu. “Bilmiyorum” talimatının gerçekten çalıştığı yer.
- Gecikme. Retriever süresi ile üretici süresi ayrı. p95 ikisinin toplamı değildir; kuyruk da vardır.
Altın set, demo sorularından değil, destek kuyruğundan ve gerçek sözleşmelerden çıkar. On soruluk bir liste model seçtirir, pipeline seçtirmez. Değişiklikten sonra aynı seti yeniden koşturmadan parça boyunu veya top_k’yı oynatmayın.
Ne zaman Haystack
| İhtiyaç | Daha doğru adres |
|---|---|
| Tek sohbet, belge yok | Doğrudan vLLM veya hosted API |
| Parçala, ara, sırala, cevapla, ölç | Haystack |
| Akış tek embed ve tek generate, dallanma yok | İnce bir kendi servisiniz de yeter |
| Adım sayısı soruya göre değişen araç çağrısı | Haystack Agent, ya da aynı işi gören başka bir graf |
| Yalnızca vektör sorgusu, pipeline yok | Store’un kendi istemcisi |
LangChain ve LlamaIndex aynı katmanda durur. Haystack’i seçmenin pratik gerekçesi, graftın açık soketlerle kurulması, YAML’a dökülüp gözden geçirilmesi ve evaluator’ların retriever ile generator’ı ayrı skorlamasıdır. “Hepsini bir framework yapsın” diye alınan, içinde iki çağrı olan bir sarmalayıcı ise sadece bir bağımlılıktır.
Özet
Haystack modeli çalıştıran motor değil, belgeden cevaba giden graftır. İndeks ile sorgu ayrı pipeline’dır. Store metadata ve kiracı filtresini taşır. Hibrit arama ve ranker, modele giden pasajı kısar. Generator OpenAI uyumlu adrese, yani vLLM’e bakabilir. Dışarıya Hayhooks ile çıkar; .NET tarafı bu HTTP sözleşmesini çağırır.
İlk iş bir agent kurmak değil, doğru pasajın ilk beşe girip girmediğini ölçmektir. O skor yoksa prompt’u parlatmak, eksik indeksi örtmez. Hattı nereye bağladığınızı, store’a mı yoksa üreticiye mi, yazarsanız sonraki not oradan devam eder.