On-Premise Document AI: OCR, VLM ve Açık Kaynak Modelleri Üretime Taşımak
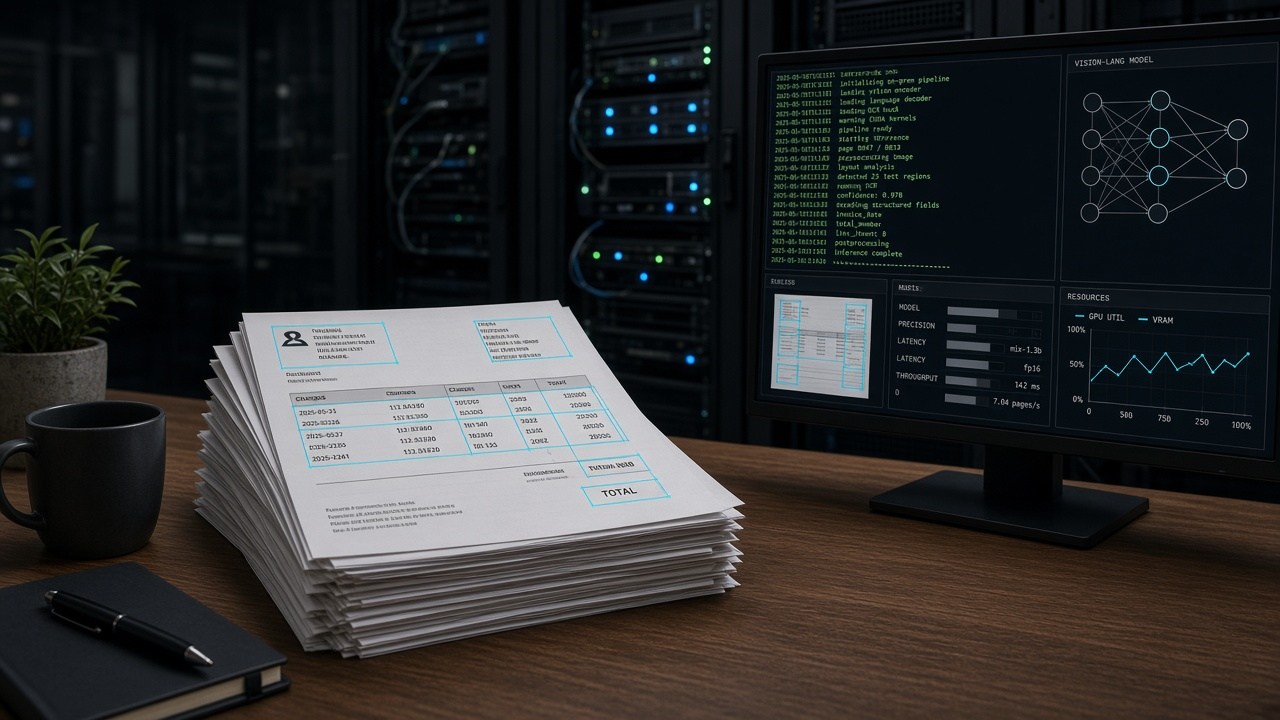
Kurumsal doküman işi çoğu zaman şöyle başlıyor: “PDF’i okuyup şu alanları JSON’a dökün.” İlk bakışta OCR + birkaç regex. Production’a gelince iş değişiyor. Tarama kalitesi kötü, layout her sayfada farklı, tablo kaymış, imza üstüne yazı binmiş, confidance düşük satırlar sessizce yanlış veri üretiyor. Üstüne bir de veri dışarı çıkmasın deniyor.
Bu yazı, hazır Document AI API’si çağırmanın ötesinde; ham dokümandan güvenilir ve yapılandırılmış veri çıkaran on-premise pipeline’ı nasıl kurduğumuza dair saha notu. Odak: OCR, layout/field extraction, validation, açık kaynak VLM/LLM’leri lokal GPU’da çalıştırmak ve gerektiğinde fine-tune / quantize / optimize etmek.
Hazır API ile Document AI arasındaki fark
Cloud Document AI veya GPT Vision ile PoC çıkarmak kolay. Üretimde üç şey kırıyor:
- Veri egemenliği: Fatura, kimlik, sözleşme, tıbbi form — çoğu kurum “API’ye gitsin” demiyor.
- Maliyet / hacim: Günlük on binlerce sayfa olunca token veya page pricing sürdürülemez hale geliyor.
- Kontrol: Model seçimi, confidence eşiği, hata sınıfı, retry, human-in-the-loop — bunlar sizin pipeline’ınızda olmak zorunda.
Bu yüzden “PaddleOCR’u çağırdık, bitti” ile “uçtan uca Document AI sistemi” aynı şey değil. İlki araç kullanımı; ikincisi mimari.
Uçtan uca pipeline nasıl görünüyor?
Benim kurduğum akış kabaca şöyle:
- Ingest: PDF / TIFF / JPEG; multipage split, DPI normalize, duplicate detection.
- Preprocessing: deskew, denoise, contrast, crop, blank-page drop. OCR kalitesinin yüzde 30–40’ı burada kazanılıyor.
- OCR / layout: metin + bounding box + reading order. Sayfa tipi (form / fatura / serbest metin) için lightweight classifier.
- Field extraction: klasik kurallar + VLM. Sabit formlarda template/key-value; değişken layout’ta VLM ile schema-guided extraction.
- Validation & confidence: alan bazlı skor, cross-field check (TCKN checksum, KDV tutarlılığı, tarih aralığı), low-confidence → review queue.
- Export: versioned JSON/XML, audit log, idempotent reprocess.
Kritik nokta: extraction’ı “model bir şey söyledi” sandığı yerde bırakmamak. Model çıktısı bir öneri; sistem çıktısı validation’dan geçmiş veri.
OCR katmanı: ne zaman yeter, ne zaman yetmez?
Tesseract ve PaddleOCR, temiz taranmış, yüksek kontrastlı sayfalarda hâlâ çok iş görüyor. Ama:
- El yazısı / karışık dil / damgalı fatura
- İç içe tablo + header merge
- Düşük DPI mobil fotoğraf
burada klasik OCR kırılıyor. Bu noktada VLM’yi “her şeyi okuyan sihirli kutu” diye koymak da yanlış. Daha iyi yaklaşım: OCR’dan gelen text + layout’u VLM’ye context olarak vermek; mümkünse region crop’ları (invoice header, line items) ayrı ayrı sormak. Böylece hem hallucination azalır hem latency kontrol altında kalır.
On-prem VLM / LLM: Qwen ve arkadaşları
Kapalı ağda çalıştırdığımız modeller arasında Qwen ailesi (özellikle vision-capable varyantlar) ve benzeri açık kaynak VLM/LLM’ler var. Tercih sebebi basit: lisansı net, lokal GPU’da çalışıyor, Türkçe dokümanlarda kabul edilebilir taban kalite, fine-tune edilebilir.
Lokal inference tarafında pratikte şunlara bakıyorum:
- Serving: vLLM / TensorRT-LLM / Ollama (PoC) — production’da genellikle vLLM veya TensorRT hattı.
- Batching: tek sayfa latency ile throughput’u ayır. Batch size ve max tokens doküman tipine göre profile’lanmalı.
- KV cache / context window: uzun sözleşme + OCR dump şişiriyor; chunk + page-level call daha ucuz.
- GPU memory: 24GB vs 48GB kartta aynı model farklı quantization ile oturuyor ya da oturmuyor.
“Modeli indirdik, çalıştı” ile “p95 latency SLA altında, GPU utilization %70+, OOM yok” arasında bir uçurum var. İkincisi production.
Fine-tune, quantization, küçültme
Her projede full fine-tune gerekmiyor. Ama domain daraldığında (ör. belirli fatura şablonları, gümrük formları, hospital lab raporları) LoRA / QLoRA ile field extraction kalitesi belirgin artıyor.
Yaptığım tipik döngü:
- Gold set oluştur: gerçek doküman + insan doğrulamalı JSON schema.
- Baseline ölç: zero-shot VLM + OCR pipeline’ının field-level F1 / exact-match skoru.
- Hard examples’ı ayır: low confidence + human correction log’ları.
- LoRA fine-tune; eval set’i kirletme.
- AWQ / GPTQ / INT8-INT4 quantization; accuracy drop’u kabul edilebilir mi bak.
- A/B: eski model vs yeni model, aynı GPU budget.
Quantization “her zaman bedava hız” değil. Özellikle sayısal alanlarda (tutar, vergi no) 4-bit agresif quantization sessiz hata üretebiliyor. O yüzden field tipine göre ayrı eval şart: serbest metin ile IBAN aynı toleransa sahip olmamalı.
Confidence scoring olmadan Document AI yok
En çok gördüğüm hata: model çıktısını direkt ERP’ye yazmak. Production’da her alanın bir skoru olmalı.
Pratik skor kaynakları:
- OCR char/word confidence
- VLM self-consistency (aynı region’a 2 pass, uyuşmazlık)
- Schema / regex / checksum validators
- Historical distribution (bu vendor’da KDV oranı hiç X olmamış)
Skor düşükse: auto-accept etme; review kuyruğuna at veya ikinci modele escalate et. İnsan doğrulaması da pipeline’ın parçası — utanç değil, kalite kontrolü.
Performans: hız, doğruluk, kaynak
Büyük hacimde üç KPI’yi birlikte izliyorum:
- Accuracy: field-level exact match / fuzzy match (doküman tipine göre).
- Latency: p50 / p95 sayfa başına; queue wait ayrı.
- Cost: GPU-saat / 1000 sayfa.
İyileştirme sırası genelde şöyle: preprocessing → regioning → model küçültme → batching → caching (aynı template hash). En pahalı GPU çağrısını en az sayıda ve en küçük crop ile yapmak, “daha büyük model al”tan önce geliyor.
Teknik liderlik tarafı
Document AI ekibinde model seçimi duygusal olmamalı. “En yeni VLM” her zaman doğru cevap değil. Bazen klasik OCR + kurallar %95’i çözer; VLM sadece long-tail’e kalır. Liderlik burada: PoC’yi production kriterine bağlamak, eval set’i kutsal saymak, GPU kapasitesini roadmap’e yazmak.
Ayrıca Python / PyTorch / CUDA hattı ile backend entegrasyonu (benim tarafımda çoğu zaman .NET API + queue worker) ayrı dünyalar gibi görünmesin. Inference servisi bir mikroservis; contract’ı version’lı JSON schema, health check, model version header.
Bu rol için “yeterli değil” dediğim şeyler
İş ilanlarında doğru söyleniyor; ben de aynı çizgiyi çiziyorum:
- Sadece Tesseract / PaddleOCR wrapper yazmak
- OpenAI / Azure / Google Document AI çağırmak
- Hazır modeli lokal açıp quantization / eval’e hiç dokunmamak
- Prompt engineering ile biten PoC
Bunlar öğrenme basamağı. Production Document AI; preprocessing’ten validation’a, model lifecycle’dan GPU maliyetine kadar sahiplik istiyor.
Özet
On-premise Document AI, “model çalıştırma” değil; güvenilir veri üretim hattı. OCR ile VLM’yi doğru katmanda birleştir, confidence’ı zorunlu kıl, domain’e göre fine-tune / quantize et, her şeyi ölç. Veri dışarı çıkmayacaksa mimari de buna göre kurulur — API anahtarıyla değil, GPU, eval set ve pipeline disipliniyle.
Benzer bir sistem kuruyorsanız veya mevcut OCR hattınızı VLM ile güçlendirmek istiyorsanız, nerede takıldığınızı yazın; bir sonraki notu oradan devam ettireyim.