Kendi Şirket Dokümanlarınla Konuşan Yapay Zekâ: Local LLM ve Türkçe RAG

Şirket dokümanına soru soran asistan, modeli değiştirince çalışmaz. Çalışan kısım aramadır: belge parçalanır, gömülür, soruya en yakın parça bulunur, model yalnızca o parçadan cevaplar.
Bu yazı, local LLM ve RAG serisinin uygulama halkası. Local LLM modelin nerede çalıştığını, vector database aramanın ne olduğunu, Docling ve Markitdown belgenin metne dönmesini, Ollama modeli ayağa kaldırmayı anlatıyor. Burada bu parçaları bir .NET uygulamasında, Türkçe sözleşme ve prosedür setiyle birbirine bağlıyorum.
Ne işe yarar, ne işe yaramaz
RAG, modelin şirketi "öğrenmesi" değildir. Modelin ağırlıkları durur. Her soruda ilgili sayfalar bağlama konur, cevap o bağlamdan üretilir. Sözleşmedeki fesih süresi, prosedürdeki onay adımı, teknik şartnamedeki eşik değeri bu yüzden bulunabilir.
İşe yaramadığı yer belli. Belgede yazmayan bir sayıyı uydurur. Taranmış ve OCR'si bozuk bir PDF'te yanlış paragrafı "kaynak" diye gösterir. İki belgedeki çelişkiyi fark etmez; daha yüksek skorlu parçayı okur. Bunu sohbet kalitesiyle kapatamazsınız. Kaynak göstermeyen ve "bilmiyorum" diyemeyen bir asistan, şirket dokümanı işinde kullanılamaz.
Türkçe metin neden ayrı bir iş
İngilizce bir demo, Türkçe sözleşmede dağılır. Ekler yüzünden aynı kavram çok farklı dizilir: fesih, feshedilmesi, feshedilmiş sayılır. Karakter sayarak kesilen bir parça, kelimeyi ortasından böler. Madde numarası, sözleşme kodu ve tarih ise anlamsal aramada zayıftır; "MADDE 7.2" tam eşleşme ister.
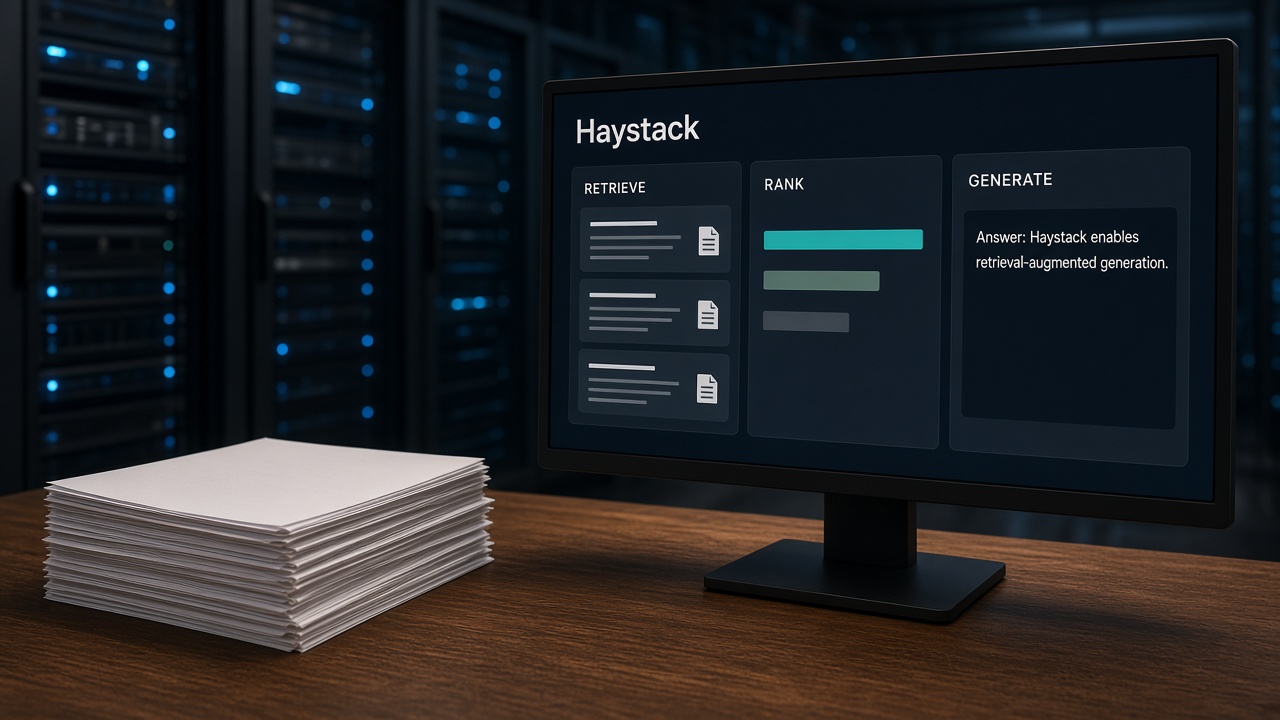
Embedding modeli burada belirleyici. İngilizce ağırlıklı nomic-embed-text kısa notlarda idare eder. Sözleşme, yönetmelik ve teknik şartname için çok dilli bge-m3 daha sağlam durur. Vektör boyutu 1024'tür. Üretim modeli olarak Türkçe cevapta Qwen2.5 14B sınıfı, tek bir GPU'da makul bir başlangıçtır. Hangi kartta hangi modelin oturduğu VRAM yazısında. Trafik ve birden fazla istek gelince servis katmanı vLLM tarafına kayar. Pipeline'ı büyütmek isterseniz Haystack aynı akışı bileşen olarak tutar. Bu yazıdaki kod, o çatıya geçmeden önceki sade .NET halidir.
Dört adım
Akış değişmez. Belge markdown olur, parça parça gömülür, soru aynı modelle gömülür, en yakın parçalar modele verilir. PostgreSQL + pgvector tek makinede hem metni hem vektörü tutar. Ayrı bir vektör ürünü, milyonlarca parça ve filtre ihtiyacı çıkınca gerekir.
1. Belgeyi metne çevirin
Metin katmanı olan PDF'i Docling ile markdown'a çevirin. Taranmış sayfa, tablo ve antetli evrak için OCR ve görüntü modeli gerekir. Onu on-prem doküman AI yazısında ayırmıştım. .NET tarafı bu işi kendisi yapmaz. Bir worker, dosyayı Docling sürecine verir, dönen markdown'ı parçalar.
Parça boyunu karaktere göre değil, cümle sınırına göre seçin. Sözleşmede 400–800 token, yüzde 10–15 bindirme iş görür. Her parçanın yanında dosya adı ve sayfa numarası dursun. Cevabın kaynağı bu iki alandır. Kaynağı sonradan "model söylesin" diye prompt'a bırakırsanız, model olmayan bir sayfa numarası yazar.
2. Parçayı gömün
Ollama 0.4 ve sonrasında embedding ucu /api/embed. Model adı, ingest ile soru tarafında aynı olmak zorunda. Biri bge-m3, diğeri başka bir model olursa skorlar anlamsızdır. Boyut da tabloyla uyumlu olmalı.
public sealed class OllamaClient
{
    private readonly HttpClient _http;

    public OllamaClient(HttpClient http) => _http = http;

    public async Task<float[]> EmbedAsync(string text, CancellationToken ct)
    {
        var payload = new { model = "bge-m3", input = text };
        using var response = await _http.PostAsJsonAsync("/api/embed", payload, ct);
        response.EnsureSuccessStatusCode();
        var body = await response.Content.ReadFromJsonAsync<EmbedResponse>(ct);
        return body!.Embeddings[0];
    }

    private sealed class EmbedResponse
    {
        public float[][] Embeddings { get; set; } = [];
    }
}
HttpClient taban adresi http://localhost:11434 olsun. Timeout'u kısa tutmayın. İlk çağrı modeli belleğe alır.
3. pgvector'a yazın
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE document_chunk (
    id          bigserial PRIMARY KEY,
    source_name text NOT NULL,
    page_no     int,
    content     text NOT NULL,
    embedding   vector(1024) NOT NULL
);

CREATE INDEX document_chunk_embedding_hnsw
    ON document_chunk
    USING hnsw (embedding vector_cosine_ops);
.NET tarafında Pgvector.Npgsql paketi, NpgsqlDataSourceBuilder.UseVector() ile parametreyi vektör tipine bağlar. Parça metnini ve new Vector(floats) değerini aynı satıra yazın. Metni vektörden ayrı bir yerde tutarsanız, kaynak göstermek için ikinci bir okuma gerekir ve ikisi bir gün kayar.
4. Soruyu aynı uzayda arayın
SELECT source_name, page_no, content,
       1 - (embedding <=> @q) AS score
FROM document_chunk
ORDER BY embedding <=> @q
LIMIT 5;
<=> kosinüs uzaklıktır. Küçük olan daha yakındır. 1 - uzaklık benzerliğe döner. Eşiği sabit bir sayı diye ezberlemeyin. Kendi soru listenizle bakın: doğru parçanın skoru nerede kümeleniyor, alakasız parça nerede kalıyor. En iyi skor eşiğin altındaysa modeli hiç çağırmayın. "Bu belgelerde yok" cevabı, uydurulmuş bir maddeden iyidir.
Bağlamı kurarken parçanın dosya adını ve sayfasını metnin içine yazın. Prompt kısa kalsın.
var prompt = $"""
    Yalnızca aşağıdaki parçalara dayanarak cevap ver.
    Parçada yoksa "bu belgelerde yok" de. Sayı, süre ve madde uydurma.
    Her hükmün sonunda kaynak adını ve sayfayı parantez içinde yaz.

    Soru: {question}

    Parçalar:
    {context}
    """;

var payload = new
{
    model = "qwen2.5:14b",
    stream = false,
    messages = new[]
    {
        new { role = "user", content = prompt }
    }
};
Uç /api/chat. Dönüşteki message.content cevaptır. API yanıtına, modelin yazdığı kaynağın yanında, sizin seçtiğiniz parça listesini de koyun. Kullanıcı sayfayı açabilsin. Modelin cümlesi ile gerçek parça ayrı kalsın.
Üretime çıkmadan kontrol
Kiracı veya şirket kodu yoksa, A firmasının sözleşmesi B firmasının sorusunda gelir. Filtre, sıralamadan önce SQL'de olsun. Prompt'a "sadece bu şirkete bak" yazmak filtre değildir.
Otuz gerçek soruluk bir liste tutun. Sözleşmeden, prosedürden, tablodan. Her yayın öncesi aynı listeyi çalıştırın. Doğru parça ilk beşte mi, model belgede olmayan sayı yazmış mı, "yok" demesi gerekirken cevap vermiş mi. Bu liste olmadan model değiştirmek tahmin olur.
Şirket belgesi genel bir LLM API'sine gitmemeli. Sözleşme, müşteri evrakı ve personel dokümanı kişisel veri taşır. Model kendi sunucunuzdaysa veri dışarı çıkmaz. Bu sınırın neden teknik bir tercih değil uyum meselesi olduğu, KVKK kontrol listesinde.
Nereden devam edilir
Tek klasörlük bir pilot için Ollama, pgvector ve yukarıdaki iki uç yeter. Belge kalitesi düşünce önce modeli büyütmeyin. Önce OCR'ye, parça sınırına ve skora bakın. Cevap yanlışsa çoğu zaman parça da yanlıştır.